5/31/2018

SESIONES TEÓRICAS ESTADÍSTICA Y TIC: SEMANA 13.

¡¡Hola a todos!! ❤
Esta semana hemos dado el TEMA 12 CORRELACIÓN Y CONCORDANCIA. 

¿Qué es la regresión?
Es la predicción de una medida basándonos en el conocimiento de otra. Nuestro objetivo será intentar reconocer si hay relación entre las variables, de qué tipo, y si es posible predecir el valor de una de ellas en función de la otra.
Dichas observaciones pueden ser representadas en un diagrama de dispersión (“scatterplot”).

En cuanto al modelo de regresión utilizado, tratamos el modelo de regresión lineal simple, que es el que se usa para 1 variable explicativa. Se trata de estudiar la asociación lineal entre dos variables cuantitativas. Se relacionan únicamente una variable independiente con otra dependiente.

y=β1+β0
Siendo:

β₁= pendiente de la recta. Expresa la cantidad de cambio que se produce en la variable dependiente por unidad de cambio de la variable independiente.

β₀= punto de intersección con el eje de coordenadas. Expresa cuál es el valor de la variable dependiente cuando la independiente vale cero.


¿Qué modelos lineales existen?


Modelos lineales deterministas: La variable independiente determine el valor de la variable dependiente. Entonces para cada valor de la variable independiente sólo habría un valor de la dependiente

Modelos lineales probabilísticos: Para cada valor de la variable independiente existe una distribución de probabilidad de valores de la dependiente, con una probabilidad entre 0 y 1.

La recta por determinar es aquélla con la menor distancia de cada punto a ella.

Análisis de correlación


El análisis de correlación se utiliza con el propósito de disponer de un indicador cuantitativo que permite sintetizar el grado de la asociación entre variables.
  • Coeficiente de Correlación r de Pearson (r), (R x y): Es un coeficiente que mide el grado de la relación de dependencia que existe entre las variables (x, y), cuyos valores van desde –1, correspondiente a una correlación negativa perfecta, hasta 1, correspondiente a una correlación positiva perfecta. Si el resultado es de 1 o -1, la variable es totalmente determinante. También indica cuan cerca están los puntos de la recta.
Teniendo una nube de puntos, ¿cómo elegir la recta que mejor se ajuste a esos puntos?: mediante el método de los mínimos cuadrados. Se trata de la recta que hace mínimo el cuadrado de la suma de las distancias verticales desde ella hasta cada uno de los puntos de la nube.

  • Coeficiente de Correlación por Rango de o rho de Spearman: Es una medida de asociación que requiere que ambas variables en estudio sean medidas por lo menos en una escala ordinal.


¡¡Y hasta aquí el último tema de la asignatura!! Si tenéis alguna duda, no dudéis en preguntadme. 

💃💟 

SESIONES TEÓRICAS ESTADÍSTICA Y TIC: SEMANA 12.

¡Hola mis queridos lectores! Ya va quedando menos 👏👏.
Esta semana hemos dado TEMA 11: PRUEBAS NO PARAMÉTRICAS MÁS UTILIZADAS EN ENFERMERÍA. La prueba de Chi Cuadrado. Corrección de Yates. Prueba exacta de Fisher. Prueba de McNemar.


Pruebas no paramétricas: Análisis bivariado de variables cualitativas: Test de hipótesis Chi-cuadrado

Se utiliza para comparar dos variables cualitativas (dependiente e independiente)

Tablas de contingencia. Frecuencias absolutas

Se emplean para registrar y analizar la asociación entre dos o más variables de naturaleza cualitativa (nominales u ordinales).

Pregunta de investigación: ¿Existe asociación entre el sexo y el consumo de tabaco?
Hipótesis:
    • Ho=No existe asociación entre el sexo y el consumo de tabaco 
    • H1=Existe asociación entre el sexo y el consumo de tabaco
Prueba chi-cuadrado

La prueba o estadístico Chi cuadrado se utiliza para comprobar si la diferencia en los datos que observamos:
  • Es debida al azar. Aceptamos la Ho 
  • Es debida a algo más, por ejemplo una asociación entre las variables que estudiamos. Aceptamos la H1.
Condiciones para aplicar la Chi cuadrado
  • Las observaciones deben ser independientes
  • Utilizar en variables cualitativas
  • Más de 50 casos 
  • Las frecuencias teóricas o esperadas en cada casilla de clasificación no deben ser inferiores a 5.
  • Si no se cumplen los requisitos: Se usan pruebas paramétricas 
    • Utilizar el estadístico de Fisher 
    • Corrección de continuidad de Yates
Fórmula

𝑋2 = ∑  (𝑓𝑟𝑒𝑐𝑢𝑒𝑛𝑐𝑖𝑎𝑠 𝑜𝑏𝑠𝑒𝑟𝑣𝑎𝑑𝑎𝑠𝑓𝑟𝑒𝑐𝑢𝑒𝑛𝑐𝑖𝑎𝑠 𝑒𝑠𝑝𝑒𝑟𝑎𝑑𝑎𝑠)2 / 𝑓𝑟𝑒𝑐𝑢𝑒𝑛𝑐𝑖𝑎𝑠 𝑒𝑠𝑝𝑒𝑟𝑎𝑑𝑎𝑠


¡Y hasta aquí el tema 11 chicos!

Seguid trabajando, y no olvidéis que...


5/30/2018

SESIONES TEÓRICAS ESTADÍSTICA Y TIC: SEMANA 11.

¡Buenas mis queridos lectores! 💪
Parece mentira que esta semana hayamos dado el TEMA 10: ESTIMACIÓN Y/O SIGNIFICACIÓN ESTADÍSTICA. 


¿Qué es la significación estadística?
  • Es una de las dos formas de inferencia estadística (el resto están explicadas en el anterior post). 
  • Permite contrastar hipótesis y relacionarlo con el método científico 
  • Se parte de la hipótesis nula, frente a la hipótesis alternativa 
  • Permite calcular el nivel de significación 
  • Nos permite tomar decisiones, cuantificando el error
Hipótesis estadística 
  • Es una creencia sobre los parámetros de una o más poblaciones 
  • Es una proposición sobre la distribución de probabilidad de una variable 
  • Siempre son proposiciones sobre la población, no sobre la muestra 
  • Son conjeturas que se hacen antes de empezar el muestreo 
  • Pretenden comprobar si las diferencias encontradas en la muestra del estudio se pueden generalizar a la población 
  • Para ello se construye un modelo teórico en el que se formula una hipótesis:
    • Hipótesis nula (H0 ): Contempla la no existencia de diferencias entre los parámetros que se comparan 
    • Hipótesis alternativa (H1 ): Contempla la existencia de diferencias entre los parámetros que se comparan
  • Mediante el contraste de hipótesis, explicado en el anterior post, procedemos a determinar si aceptamos o rechazamos la hipótesis nula:
    • Si p>0,05: en este caso no podemos rechazar la hipótesis nula (no podemos decir que sea cierta, sino que no podemos rechazarla) 
    • Si p<0,05: en este caso rechazamos la hipótesis nula, por lo que debemos aceptar la hipótesis la hipótesis alternativa.
Tipos de errores en test de hipótesis


TIPOS DE ANALISIS ESTADISTICOS SEGÚN EL TIPO DE VARIABLES IMPLICADAS EN EL ESTUDIO


¡Y hasta aquí el tema chicos! Espero que tengáis un buen día. 💛

SESIONES TEÓRICAS ESTADÍSTICA Y TIC: SEMANA 10.

¡Buenas a todos!
Esta semana hemos dado el TEMA 9: INTRODUCCIÓN A LA INFERENCIA ESTADÍSTICA. INTERVALOS DE CONFIANZA Y CONTRASTE DE HIPÓTESIS

Este tema es necesario para entender los próximos, por lo que si tenéis cualquier duda, ¡no dudéis en preguntadme!

¿A qué se le llama inferencia estadística?

Al conjunto de procedimientos estadísticos que permiten pasar de lo particular, la muestra, a lo general, la población, le denominamos inferencia estadística 

Existen dos formas de inferencia estadística: 

  • ESTIMACIÓN del valor en la población (Parámetro) a partir de un valor de la muestra (Estimador). Puede ser: 
    • Puntual: Consiste en considerar al valor del estadístico muestral como una estimación del parámetro poblacional.
    • Por intervalos: Consiste en calcular dos valores entre los cuales se encuentra el parámetro poblacional que queremos estimar con una probabilidad determinada, habitualmente el 95% 
  • CONTRASTE DE HIPÓTESIS, a partir de valores de la muestra, se concluye si hay diferencias entre ellos en la población. Pueden ser:
    • Métodos paramétricos: T-Student, Anova, Fisher y Pearson.
    • Métodos no paramétricos: U-Mann Whitney, K-w y tablas de contingencia.           

¿Qué es el error estándar?

·        El error estándar de cualquier estimador mide el grado de variabilidad en los valores del estimador en las distintas muestras de un determinado tamaño que pudiésemos tomar de una población.
  • Error estándar para una media: s/√¯n 
  • Error estándar para una proporción: √¯p(1-p)/n
Teorema central del límite:
  • Para estimadores que pueden ser expresados como suma de valores muestrales, la distribución de sus valores sigue una distribución normal con media de la de la población y desviación típica igual al error estándar del estimador de que se trate.
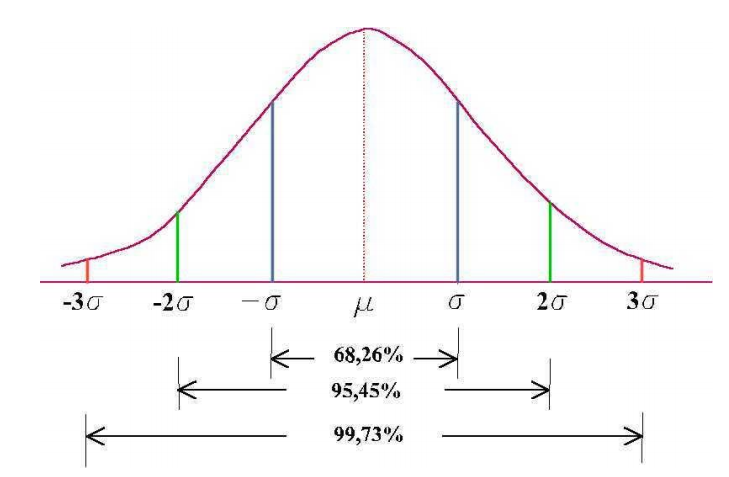
  • Si sigue una distribución normal, sigue los principios básicos de ésta: 
    • ± 1S 68,26% de las observaciones 
    • ± 2S 95,45% de las observaciones 
    • ± 1,95S 95% de las observaciones 
    • ± 3S 99,73% de las observaciones 
    • ± 2,58S 99% de las observaciones

¿Qué son los intervalos de confianza?
  • Son un medio de conocer el parámetro en una población midiendo el error que tiene que ver con el azar (error aleatorio) 
  • Se trata de un par de números tales que, con un nivel de confianza determinados, podamos asegurar que el valor del parámetro es mayor o menor que ambos números. 
  • Se calcula considerando que el estimador muestral sigue una distribución normal, como establece la teoría central del límite 
  • Mientras mayor sea la confianza que queramos otorgar al intervalo, éste será más amplio, es decir el extremo inferior y el superior del intervalo estarás más distanciados y, por tanto, el intervalo será menos preciso.
Contrastes de hipótesis
  • Sirven para controlar los errores aleatorios
  • El método es el siguiente:
    1. Establecemos a priori una hipótesis acerca del valor del parámetro 
    2. Realizamos la recogida de datos
    3. Analizamos la coherencia de entre la hipótesis previa y los datos obtenidos
  • Por tanto, son herramientas estadísticas para responder a preguntas de investigación: permite cuantificar la compatibilidad entre una hipótesis previamente establecida y los resultados obtenidos 

Errores de hipótesis

  • El error α es la probabilidad de equivocarnos al rechazar la hipótesis nula 
  • El error α más pequeño al que podemos rechazar H0 es el error p Habitualmente rechazamos H0 para un nivel α máximo del 5% (p<0.05).
Y aquí termina el tema, chicos. Espero que os haya quedado claro con la explicación. 
¡Hasta la próxima!


5/02/2018

SESIONES TEÓRICAS ESTADÍSTICA Y TIC: SEMANA 9.

¡Buenas mis queridos lectores!😻
¿Qué tal va vuestra semana? Espero que bien.
Esta semana hemos dado el TEMA 8: TEORÍA DE MUESTRAS.

¿Qué es un muestreo?
Un muestreo es un método tal que al escoger un grupo pequeño de una población podamos tener un grado de probabilidad de que ese pequeño grupo posea las características de la población que estamos estudiando

Tipos de muestreo
  • MUESTREO NO PROBABILÍSTICO: No sigue el proceso aleatorio. No puede considerarse que la muestra sea representativa de una población.
      • Por conveniencia: En el que el investigador decide, según sus objetivos, los elementos que integrarán la muestra, considerando las unidades “típicas” de la población que desea conocer.
      • Por cuotas: En el que el investigador selecciona la muestra considerando algunos fenómenos o variables a estudiar, como: Sexo, raza, religión, etc.
      • Accidental: Consiste en utilizar para el estudio las personas disponibles en un momento dado, según lo que interesa estudiar. De las tres es la más deficiente.
  • MUESTREO PROBABILÍSTICO: Sigue el proceso aleatorio. Todos y cada uno de los ELEMENTOS tienen una probabilidad calculable y, por lo tanto, conocida, de ser elegidos para la muestra. 
    • Conglomerados: Se usa cuando no se dispone de una lista detallada y enumerada de cada una de las unidades que conforman el universo y resulta muy complejo elaborarla. En la selección de la muestra en lugar de escogerse cada unidad se toman los subgrupos o conjuntos de unidades “conglomerados”.
    • Estratificado: Se caracteriza por la subdivisión de la población en subgrupos o estratos, debido a que las variables principales que deben someterse a estudio presentan cierta variabilidad o distribución conocida que puede afectar a los resultados.
    • Aleatorio sistemático: Similar al aleatorio simple, en donde cada unidad del universo tiene la misma probabilidad de ser seleccionada.
    • Aleatorio simple: Se caracteriza porque cada unidad tiene la probabilidad equitativa de ser incluida en la muestra: 
        • De sorteo o rifa: Desventaja de este método es que no puede usarse cuando el universo es grande. 
        • Tabla de números aleatorios: más económico y requiere menor tiempo.
Tamaño de la muestra

Podemos calcular el tamaño de la muestra:
  • Para estimar la media de una población:  
  • Para estimar una proporción: 


Y esto es todo chicos. ¡Qué paséis una buena semana! 👋💖


SESIONES TEÓRICAS ESTADÍSTICA Y TIC: SEMANA 8.

¡Buenas a todos! 👀👋
Esta semana hemos dado el TEMA 7: TEORÍA DE LA PROBABILIDAD
El concepto de probabilidad es muy frecuente para comunicarnos y entendernos.
Se expresa mediante un número entre 0 y 1 (o en porcentajes).
En los casos de probabilidad no existe la certeza de que ocurran los hechos, existe una esperanza dimensionada y razonable, de que el hecho anunciado se vea confirmado.
Existen tres tipos de probabilidades:

  • PROBABILIDAD SUBJETIVA O PERSONALÍSTICA: Mide la confianza que el individuo tiene sobre la certeza de una proposición determinada. Este concepto de probabilidades ha dado lugar al enfoque de análisis de datos estadísticos llamado “Estadística Bayesiana”.
  • PROBABILIDAD CLÁSICA O A PRIORI: Data del siglo XVIII, desarrollada para resolver problemas relacionados con los juegos de azar.  Las probabilidades se calculan con un razonamiento abstracto.
    • LEY DE LOS GRANDES NÚMEROS:  La probabilidad a priori de que salga un número en el dado es P(A)= 1/6 = 0,166 = 16,6%

  • PROBABILIDAD RELATIVA O “A POSTERIORI”: Si el n de determinaciones (repeticiones de un experimento aleatorio) es grande, podemos esperar que la probabilidad observada se acerque a la probabilidad teórica.

EVENTOS O SUCESOS.


Cuando se realiza un experimento aleatorio diversos resultados son posibles. El conjunto de todos los resultados posibles se llama espacio muestral (S). Se llama suceso o evento a un subconjunto de dichos resultados.


  • Se llama evento complementario de un suceso A, al formado por los elementos que no están en A y se denota Ac.

  • Se llama evento unión de A y B, al formado por los resultados experimentales que están en A o en B (incluyendo todos los que están en ambos).

  • Se llama evento intersección de A y B, al formado por los elementos que están en A y B.


PROPIEDADES LAS PROBABILIDADES


REGLAS BÁSICAS: TEORÍA DE LA PROBABILIDAD.

  • Las probabilidades siempre oscilan entre 0 y 1. 
  • La probabilidad de un suceso contrario es igual a 1 menos la probabilidad del suceso 
P(A´) = 1 - P(A)

  • La probabilidad de un suceso imposible es 0. 
  • La unión de A y B es: P (AuB) = P(A) + P(B) - P(AnB) 
  • La probabilidad condicionada de un suceso A a otro B se expresa: P(A/B) = P(A I B) / P(B) Si P(B) =/= 0
TEOREMA DE BAYES.
Expresa la probabilidad condicional de un evento aleatorio A dado B en términos de la distribución de probabilidad condicional del evento B dado A y la distribución de probabilidad marginal de sólo A.


DISTRIBUCIÓN BINOMIAL
Es un modelo matemático de distribución teórica de (la normal es con variables continuas) variables discretas.
DISTRIBUCIÓN DE POISSON
También se llama la distribución de probabilidad de casos raros
  • La distribución de Poisson se utiliza en situaciones donde los sucesos son impredecibles o de ocurrencia aleatoria. En otras palabras no se sabe el total de posibles resultados. 
  • Permite determinar la probabilidad de ocurrencia de un suceso con resultado discreto. 
  • Es muy útil cuando la muestra o segmento n es grande y la probabilidad de éxitos p es pequeña. 

DISTRIBUCIONES NORMALES


Captura


Extrapolando aparecen los principios básicos de las distribuciones normales y podemos tipificar valores de una normal:


– ± 1S 68,26% de las observaciones


– ± 2S 95,45% de las observaciones


– ± 1,95S 95% de las observaciones


– ± 3S 99,73% de las observaciones


– ± 2,58S 99% de las observaciones

La tipificación de la valores se puede realizar sí … 

  • Trabajamos con una variables continuas que: 

– Sigue una distribución normal (TLC)


– Y tiene más de 100 unidades (LGN)


  • La tipificación nos permite conocer si otro valor corresponde o no a esa distribución de frecuencia.
Captura


Sabemos por la forma de la curva que…
  • Media +/- 1 desviación típica: 68% 
  • Media +/- 2 desviación típica: 95% 
  • Media +/- 3 desviación típica: 99% 
Y hasta aquí el tema 7. Espero que se haya entendido. ¡Hasta pronto!

SESIONES TEÓRICAS ESTADÍSTICA Y TIC: SEMANA 7.

¡Buenas a todos mis queridos lectores! 💛
Siento mucho haber estado tan desaparecida. Han sido semanas intensas, pero.. ¡ya estoy de vuelta!
La semana 7 dimos el TEMA 6: REPRESENTACIÓN GRÁFICA DE LA INFORMACIÓN: Representación variables cualitativas y cuantitativas discretas. Representación de variables cuantitativas continuas. Errores en las representaciones.

Las REPRESENTACIONES GRÁFICAS MÁS EMPLEADAS son:

VARIABLES CUALITATIVAS:

  • Gráfico de sectores (dicotómicas o policotómicas con pocas categorías)

  • Gráfico de barras (policotómicas)

  • Pictogramas (policotómicas)


VARIABLES CUANTITATIVAS:

  • Gráfico de barras (sólo para variables discretas con bajo rango de valores) 


  • Histogramas (variables continuas) 


  • Polígonos de frecuencia (variables continuas) 

  • Gráfico de tronco y hojas (variables continuas) 


DATOS BIDIMENSIONALES Y MULTIDIMENSIONALES:

  • Tendencias temporales

  • Nubes de puntos (scatter plot)


  • Otros gráficos multidimensionales (diagramas de estrellas…): Cada vértice representa una variable.